


Transformer 아키텍처는 Vaswani 등의 "Attention Is All You Need" 논문에 소개된 이후 자연어 처리 및 기타 영역 분야에 혁명을 일으켰습니다. Transformer의 핵심에는 입력 시퀀스를 처리하는 데 중요한 역할을 하는 인코더가 있습니다. 이 블로그에서는 변환기 공급업체로서 Transformer 인코더의 내부 작동 방식을 자세히 살펴보고 주요 구성 요소와 이들이 상호 작용하여 입력 데이터를 의미 있는 표현으로 변환하는 방법을 설명하겠습니다.
변압기 인코더의 전체 구조
Transformer 인코더는 서로 적층된 여러 개의 동일한 레이어로 구성됩니다. 각 레이어는 두 개의 주요 하위 레이어, 즉 다중 헤드 자기 주의 메커니즘과 피드포워드 신경망으로 구성됩니다. 인코더는 토큰의 입력 시퀀스를 사용하며, 여기서 각 토큰은 먼저 벡터 표현에 포함됩니다.
입력 임베딩을 살펴보는 것부터 시작해 보겠습니다. 입력 토큰은 일반적으로 자연어 처리 작업의 단어 또는 하위 단어입니다. 이러한 토큰은 임베딩 레이어를 통해 고정 길이 벡터로 변환됩니다. 임베딩 레이어는 각 토큰을 고차원 공간의 벡터에 매핑하여 모델이 토큰에 대한 의미 및 구문 정보를 캡처할 수 있도록 합니다.
멀티 헤드 셀프 어텐션
멀티 헤드 셀프 어텐션 메커니즘은 Transformer 인코더의 가장 독특한 특징입니다. 이를 통해 모델은 다양한 위치에서 입력 시퀀스의 다양한 부분에 주의를 기울일 수 있습니다. self-attention 메커니즘은 쌍별 관계를 기반으로 입력 벡터의 가중 합을 계산합니다.
self-attention이 어떻게 작동하는지 이해하려면 먼저 쿼리(Q), 키(K), 값(V)의 세 가지 행렬을 소개해야 합니다. 입력 시퀀스의 각 입력 벡터(x_i)에 대해 (x_i)에 세 가지 다른 가중치 행렬(W^Q), (W^K) 및 (W^V)를 각각 곱하여 쿼리(q_i), 키(k_i) 및 값(v_i)을 계산합니다.

두 위치(i)와 (j) 사이의 어텐션 점수는 쿼리(q_i)와 키(k_j) 간의 내적으로 계산됩니다. 이 점수는 (j) - 번째 위치가 (i) - 번째 위치와 얼마나 관련성이 있는지를 측정합니다. 내적이 너무 커지는 것을 방지하기 위해 내적을 키 벡터 차원의 제곱근(\sqrt{d_k})으로 나눕니다. 여기서 (d_k)는 키 벡터의 차원입니다.
그런 다음 Attention 점수는 Softmax 함수를 통해 전달되어 Attention 가중치를 얻습니다. 이러한 가중치는 값 벡터의 가중치 합계를 계산하는 데 사용됩니다. (i)번째 위치에 대한 self-attention 메커니즘의 출력은 어텐션 가중치에 의해 가중치가 부여된 시퀀스의 모든 값 벡터의 조합인 새로운 벡터(z_i)입니다.
멀티 헤드 셀프 어텐션에서는 (Q), (K), (V)에 대해 서로 다른 가중치 행렬을 사용하여 셀프 어텐션 작업을 여러 번 병렬로 수행합니다. 그런 다음 이러한 여러 self-attention 헤드의 출력을 연결하고 다른 가중치 매트릭스를 통해 투영하여 multi-head self-attention 계층의 최종 출력을 얻습니다.
다중 헤드 자기 주의 메커니즘을 통해 모델은 입력 시퀀스에서 다양한 유형의 관계를 캡처할 수 있습니다. 예를 들어, 한 헤드는 로컬 관계에 초점을 맞추고 다른 헤드는 장거리 종속성을 캡처할 수 있습니다.
피드 - 순방향 신경망
다중 헤드 Self-Attention 레이어 이후 출력은 피드포워드 신경망을 통해 전달됩니다. 피드포워드 네트워크는 ReLU 활성화 함수가 사이에 있는 두 개의 선형 레이어로 구성됩니다.
첫 번째 선형 레이어는 입력 벡터를 고차원 공간에 매핑하고 ReLU 활성화 함수는 비선형성을 도입합니다. 두 번째 선형 레이어는 ReLU의 출력을 다시 원래 차원으로 매핑합니다.
피드포워드 네트워크는 모델이 self-attention 계층에서 얻은 표현을 추가로 변환하는 데 도움이 됩니다. 입력 특징 간의 복잡한 비선형 관계를 학습하여 모델의 표현력을 향상시킬 수 있습니다.
레이어 정규화 및 잔여 연결
Transformer 인코더의 훈련 안정성과 성능을 향상시키기 위해 레이어 정규화와 잔차 연결이라는 두 가지 중요한 기술이 사용됩니다.
계층 정규화는 각 하위 계층(다중 헤드 자체 주의 및 피드 포워드 네트워크) 후에 적용됩니다. 특징 차원 전체에 걸쳐 입력 벡터를 정규화하여 훈련 프로세스를 더욱 안정적으로 만듭니다. 입력을 정규화함으로써 레이어 정규화는 훈련 중에 경사도가 사라지거나 폭발하는 것을 방지하는 데 도움이 됩니다.
스킵 연결이라고도 알려진 잔여 연결은 하위 계층의 입력을 해당 출력에 연결하는 데 사용됩니다. 하위 레이어의 출력을 다음 레이어로 전달하는 대신 하위 레이어의 입력을 출력에 추가합니다. 이를 통해 모델은 ID 매핑을 더 쉽게 학습할 수 있으며 그래디언트 소실 문제를 완화하는 데 도움이 됩니다.
애플리케이션 및 제품
Transformer 인코더는 기계 번역, 텍스트 요약, 질문 응답 시스템 등 다양한 애플리케이션에 널리 사용되었습니다. 변압기 공급업체로서 당사는 다양한 요구 사항을 충족할 수 있는 광범위한 변압기를 제공합니다.
예를 들어, 우리는건식 패드 장착형 변압기이는 안전성과 신뢰성이 중요한 실외 응용 분야에 적합합니다. 이 변압기는 열악한 환경에서 작동하도록 설계되었으며 최소한의 유지 관리만 필요합니다.
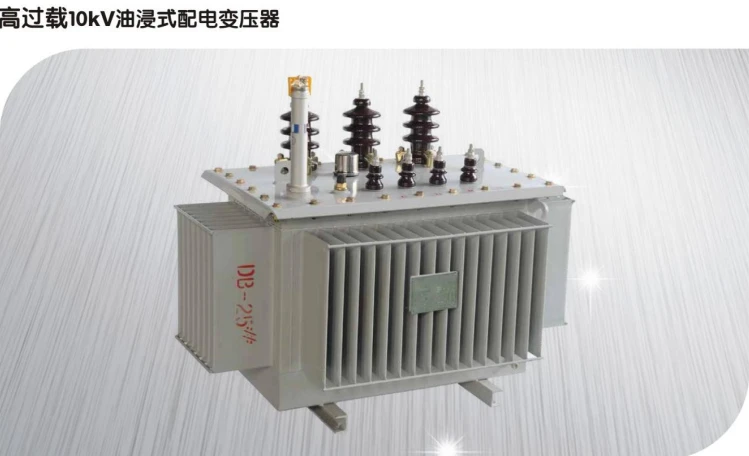
우리는 또한 제공합니다침수형 변압기, 이는 배전 시스템에서 일반적으로 사용됩니다. 침수형 변압기에는 절연유가 채워져 있어 열을 발산하는 데 도움이 되고 더 나은 전기 절연을 제공합니다.
구매 및 상담 문의
당사의 변압기 제품에 관심이 있거나 변압기 인코더 및 해당 애플리케이션에 대해 질문이 있는 경우 구매 상담을 위해 당사에 문의하시기 바랍니다. 당사의 전문가 팀은 귀하의 특정 요구 사항에 가장 적합한 변압기를 선택하는 데 도움을 드릴 준비가 되어 있습니다. 대규모 전력 프로젝트에 참여하든 소규모 산업 응용 분야에 참여하든 당사는 귀하에게 적합한 솔루션을 제공합니다.
참고자료
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, AN, ... & Polosukhin, I. (2017). 주의가 필요한 전부입니다. 신경 정보 처리 시스템의 발전, 30.


